backpass 把 AGENTS.md 當權重:改一行規則要兩個不同 observer 的逐字引文,拒絕過的提案還會被記住
一份 AGENTS.md 寫完之後,哪一行真的被 agent 遵守過,哪一行被無視,哪一行讓它做了反效果的事?這些答案其實都躺在 ~/.claude/projects/ 底下的轉錄檔裡,只是少有人回頭去對。
backpass 做的就是去對。README 的副標是 “Gradient descent for your agent memory.”,把 AGENTS.md、CLAUDE.md 和 project skills 叫作 the weights,把 session 叫作 forward pass,把轉錄檔叫作 loss signal,把你按下的 accept/reject 叫作 the human gate,還說 “One run is one bounded gradient step.”
名字取得很大。我想知道的是一次 run 底下到底動了什麼,所以從輸入端拆起。
我只讀了 README 全文,以及 src/config.js、src/tokens.js、src/analyze.js、src/distill.js 的片段。我沒有安裝 backpass,沒有跑過任何一次 backpass,所以它提案的品質、花多少錢、跑多久,我完全不知道。下面凡是「它會怎樣」的句子,都是讀文件與程式碼的結果。作者在 README 開頭連了一篇說明設計理由的文章,我只確認網址打得開,沒有讀內容,不引用。
它怎麼知道哪些 session 屬於這個 repo
backpass 直接讀七種 harness 的本機轉錄儲存:claude、codex、pi、opencode、grok、cursor CLI、hermes。README 的說法是 “No API, no upload.”,而且 “backpass has no API keys of its own”,每一次模型呼叫都透過 acpx 打到你已經登入的 harness。
Claude 的轉錄在 ~/.claude/projects/<munged-cwd>/<uuid>.jsonl,靠每一行裡的 cwd 判斷它屬於哪個 repo;codex 在 ~/.codex/sessions/YYYY/MM/DD/rollout-*.jsonl,除了 cwd 還看記錄下來的 git.repository_url。
repo 目錄可能早就搬走或刪掉了。README 因此把關聯分成四層:Tier 1 是 cwd 就在這個 repo 的 worktree 裡,Tier 1.5 是共用同一個 git remote 的同機 sibling clone,Tier 2 是轉錄裡記的 git remote 跟你的 remote 對得上,README 稱這層 “survives deletion”,Tier 3 是 best-effort,死路徑的最後一段等於 repo 目錄名,或符合你設定的 glob。--strict 會排除 Tier 3,但保留 1.5。
它還能走 SSH,把你其他機器上的 session 併進同一份語料,遠端什麼都不裝,用你自己的 ssh 把一段 Node 程式 pipe 給遠端的 node -。hosts 只能寫在個人設定檔,repo 裡的 .backpassrc.json 若放 discovery.hosts,會被 “refused by name”。我猜這是為了防止別人的 repo 設定檔叫你的機器去連某台主機,不過這是我的推測,README 沒這樣解釋。
backpass 的時間軸(GitHub 與 npm 紀錄,查詢日 2026-11-07)
2026-08-21
repo 建立(created_at 2026-08-21T21:12:31Z)。
2026-08-23
第一個 release backpass-v0.1.1。
2026-11-02
最新的 backpass-v0.1.44 發布,pushed_at 也在同一天。release 內容只有一條 Bug Fix:preserve evidence cache correctness across memory targets (#238)。
2026-11-07
我查的時候是 1,474 顆星、121 fork,MIT 授權,archived 為 false。
從 8 月 23 日到 11 月 2 日是 71 天,44 個 release。數字大不代表穩定,只代表它現在還在密集改。engines 要求 node >= 22.5.0。
把轉錄壓成一份可以讀的 trace
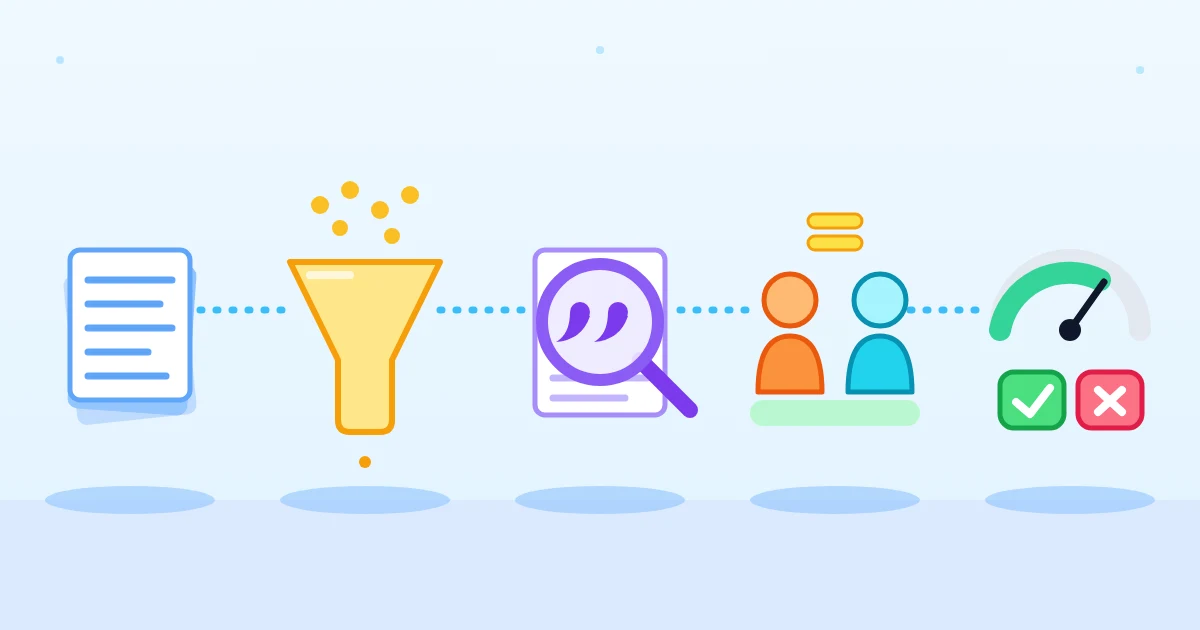
轉錄檔動輒好幾 MB,直接餵模型不可能。backpass 先做確定性蒸餾:使用者和助理的回合逐字保留,每個 tool call 壓成一行,README 的例子是 tool: Bash "npm test" -> 1 failing,tool 輸出截斷,注入的 harness 鷹架移除,秘密遮蔽。結尾附上原始轉錄的路徑,讓分析的 agent 只在某個說法非查不可的時候才開原檔。
README 說 “Typical reduction is 96-99%”,我想驗證這個數字,在 src/distill.js 裡找了一輪。找到的是截斷輸出的邏輯,裡面有一個標 “truncated” 的標註,96 到 99 這個範圍在我讀到的那段程式碼裡查不到(我只讀了片段,不能說整個專案都沒有)。所以它只能算作者的自述,我沒有任何方法判斷它對你的 session 準不準。
量太大的時候怎麼辦?maxTranscripts 預設 100,超過就做 recency-weighted sample,每份轉錄的權重每 14 天減半(sampleHalfLife),無放回,而且抽樣由轉錄自己的身分決定,README 寫的是 deterministic and sticky,重跑不會洗牌。這個細節很容易被忽略:如果抽樣每次不一樣,你拒絕過的提案下次可能因為語料換了一批又冒出來,後面講的 “rejections are remembered” 就站不住。
引文關卡,最讓我多看兩眼的地方
蒸餾後的每份 trace 會送給一個 cheap model,要求輸出嚴格 JSON:哪些指令有幫助、哪些被違反、哪些錯誤目前沒有任何指令涵蓋。負面項目分成 harm(照指令做反而出事)、non-compliance(agent 無視指令)、irrelevant,缺口帶 domain,不是 orchestration(錯在外部 harness 或工具)就是 project。
接著是整套設計我最在意的一句,README 用粗體寫:Every claim must carry a verbatim quote, and the quote must be in the trace. Quoteless items are discarded。
程式碼對得上。src/analyze.js:191 的檢查是引文 trim 之後長度要 8 個字元以上,而且必須出現在空白折疊過的 trace 裡。被丟掉的數量記在 quotesNotInTrace。引文寫進證據時截為 600 字元。例外只有一個:分析 agent 回報它去翻了原始轉錄(usedRawTranscript 為 true)時,這個比對會略過,README 的說法是那段引文可能來自蒸餾時被截掉或省略的文字。
這個關卡擋得住什麼?擋得住模型憑空編一句 agent 或使用者從沒說過的話。擋不住的是下一層:那句話確實存在,但它跟「規則有沒有效」之間的因果,是模型說的。[推測] 一句逐字引文證明了某個畫面出現過,不證明那個畫面是某條規則造成的。作者自己在 Limitations 寫了:「Causal attribution is genuinely hard. A model can confabulate influence.」緩解全部是結構性的,也就是逐字引文、兩 session 規則、負面證據加權、人工閘門。他沒有宣稱解決了。
我認為這是整份 README 最誠實的一段,也是我判斷這個工具該怎麼用的依據。
兩個 observer 才准動,拒絕了會記住
分析結果丟進聚合。缺口(gap)跨 run 記在 .backpass/gap-ledger.json,每個 observer 對同一個 gap 只算一次,某個 gap 被記憶檔或 project skill 涵蓋之後,那筆就 retire,一個 session 的 sightings 過了 90 天(gapLedgerMaxAge)就過期。README 說 “Until a gap corroborates it stays out of the proposal entirely.” 單一 session 看到的問題,不進提案。
增、改、刪「常駐載入內容」的任何編輯,都要引文來自 minGapEvidence 個不同的 corroborating observers,預設 2。README 特別強調 “Rewrites are not classified by shape: a one-session tightening is refused along with a one-session append”,只靠一個 session 的收緊,和只靠一個 session 的追加,一樣被擋。相關的轉錄(例如同一個 session 家族)算同一個 observer,所以 2 不等於兩個檔案。
| 參數 | 預設值 | 它管什麼 |
|---|---|---|
maxTranscripts |
100 | 一次 run 最多讀幾份轉錄 |
sampleHalfLife |
14d | 抽樣時每份轉錄的權重幾天減半 |
gapLedgerMaxAge |
90d | gap 的 sighting 多久後過期 |
minGapEvidence |
2 | 要幾個不同 observer 才能支持編輯 |
budgetTokens |
5000 | 常駐內容預算,記憶檔加每個 skill 的 description: 行,以 UTF-8 bytes / 4 估算 |
| 引文最短長度 | 8 字元 | 單位是字元,不是 token |
上面這些預設值,我在 src/config.js、src/tokens.js 與 src/analyze.js 逐行對過。
最讓我意外的是證據的不對稱。README 的原文:Negative evidence is weighted highest, but its class determines what it supports: non-compliance supports reinforcement, while only harm supports removal.
agent 無視了某條規則,結論是這條規則該加強,不是該刪掉。只有「照做反而出事」才算支持刪除,而且刪記憶檔裡的指令,要 minGapEvidence 個 observer(預設兩個)都給 harm 類證據。skill 檔裡的純刪除更乾脆,一律拒絕,理由是 no evidence can attribute harm to skill-file text。我讀到這裡才理解為什麼它叫 gradient descent 卻不太像在瘦身:預設的力道是往「寫得更清楚」推,要往「拿掉」推的門檻特別高。
人的閘門也有一個刻意的缺口。backpass apply 預設用 lavish-axi 開審核頁,每個編輯一張卡,有 diff、引文與出處、即時預算儀表和 ACCEPT/REJECT;--no-ui 可以在終端機審。README 寫:There is no DEFER button, and it isn’t missing: rejections are remembered. 被拒的 add、rewrite、remove,之後針對同檔、同 gap 或同指令的提案都維持被拒,除非後來的 run 背後有 strictly more sessions。
沒有「晚點再說」,逼你當下表態,表態了還會被它記到證據變多為止。我的解讀是,這跟前面抽樣由轉錄身分決定是同一個方向:結果可重現,使用者的決定才有重量。
還有一個我只在文件裡看到的保護:提案是針對特定版本的記憶檔與 skill 檔量測的,apply 前如果檔案被刪或改過,什麼都不寫,要你重跑 backpass;寫入中途失敗,會回滾這一輪建立的檔案。README 還說 backpass apply is the only command that writes。
預算滿了,新增要指名誰來付錢
預設的常駐預算是 5,000 估計 token,約 20KB。算法是記憶檔加每個 skill 的 description: 那一行,skill 內文被觸發前不算。估算器用 UTF-8 bytes 除以 4,README 自稱誤差 ±15%,所以它是粗估,不是任何一家模型的 tokenizer。中文字三個 byte 的算法下,會不會偏離,我沒有驗證。
預算滿了之後,合成的提示變成 zero-sum:每個新增都得指名由哪個移除或抽出來付。抽出去的去處是 skill。README 舉的例子是一段 640 token 的流程,只跟 4% 的 session 有關,改寫成 35 token 的 description 行,工具會報帳:−611 tok always-loaded, +35 tok description。這是 README 的示意,不是統計。
分流的規則寫得很直接:廣泛(至少 20% 的 session,或跟安全有關)進記憶檔;有條件、很窄的進 skill;觸發條件偵測不出來的,列為刪除候選。skill 的 description 本身也算權重,所以證據若顯示 agent 缺的是某個 skill 其實早就含有的知識,那算 failed trigger,提案改的是 description,不是把內容複製一份進記憶檔。
合成這一步由 high-reasoning 的 run 做。agent 在 .backpass/synthesis/ 的 staging 副本上用自己的檔案工具改,repo 本身對它唯讀,backpass 再拿 diff 對原檔,README 說 Nothing textual is ever taken from the model。我的理解是:進到審核卡上的文字,來自 diff,不來自模型自己貼出來的 patch。
我的立場
如果我要在自己的規則檔上用它,我會把它當成讀報告的工具,只跑 backpass(這個指令從不寫入),把每個提案當線索去翻原始轉錄,自己決定要不要動檔案,不會把 apply 放進任何自動流程。
原因就是前面那條縫:引文必須在 trace 裡,防的是編造;兩個 observer,防的是巧合;人工閘門,防的是整套判斷錯了。但「這句話發生過」和「它是這條規則造成的」之間,沒有任何一關在檢查,作者也承認。這個空缺只能由讀提案的人補。
會讓我改變想法的條件有兩個。第一,有人拿 accepted 的編輯,比對套用前後同一個 repo 的 non-compliance 次數,而且次數確實下降,那我就會相信這個迴圈真的會收斂。第二,README 的 Limitations 之一被解掉:作者說轉錄格式沒有文件、隨時可能變,每個 adapter 用 golden fixture 固定並 fail soft。如果哪天這七種格式有一家正式公開了規格,我對「蒐集端會悄悄壞掉」的擔心就會小很多。
反過來,如果你的專案只有幾個 session,湊不出兩個不同 observer,這套門檻大概根本放行不了任何編輯,那就不必裝。這是我從預設值推的,不是跑出來的。
另外有幾件事我沒查,不要拿這篇當依據:README 預設模型階梯寫了 gpt-5.6-luna、claude-sonnet-5、grok-4.6 這些名字,我沒查它們是否存在於各家目前的清單;acpx 和 lavish-axi 各自的維護狀態,我也沒查;同類工具有幾個,我沒做橫向調查,所以不會說它是第一個。
換成別的規則檔,這套門檻還成立嗎
backpass 的零件其實可以拆開來帶走:一個證據要有可核對的原文,一個改動要有兩個獨立來源,一個預算要有人付帳,一個被拒絕的決定要有紀錄。這四件事跟 agent 無關,換成你團隊的 runbook、lint 規則、code review 清單,都是同一種「規則檔會膨脹、而且沒人知道哪行有用」的問題。
如果你已經裝了,我會先打開 .backpass/gap-ledger.json,看它記了哪些缺口,尤其是第一個被兩個 observer 同時看到的 gap:是你自己早就知道的那條,還是你完全沒想到的。


你的鼓勵將被轉換為我明天繼續加班的動力(真的)。 ❤️